概要:◀▼
URL 筛选可让您通过包含或排除具有精确 URL、前缀匹配项和通配符模式的特定页面来缩小网络抓取程序同步范围。您可以避免同步管理员或仅限员工的内容,控制要抓取的路径,并减少手动设置。本文章介绍了包含和排除规则的工作方式,以及常见的模式示例,例如单级、多级和子域名匹配。
设置网络抓取程序时,您可以选择配置高级设置,通过添加 URL 筛选来微调同步。URL 筛选允许您使用通配符模式来定义特定路径,以缩小网站同步的范围。
您可以定义应包含和排除哪些 URL,而不是在一个宽泛的起点上同步所有内容。您可以使用精确 URL、前缀匹配和通配符模式来缩小同步范围,这有助于减少手动设置,并避免同步不相关的页面,例如管理员或仅限员工的组别。
- 首先评估排除筛选。如果 URL 与排除筛选匹配,即使与包含筛选匹配,它也会被拒绝。
- 包含筛选用作指定时的允许列表
- 如果未配置筛选,则允许所有 URL。
了解 URL 筛选模式
设置网络抓取程序时,您可以使用设置工作流程中的可选 URL 发现标签来定义使用通配符的 URL 筛选,以指定您要同步的确切页面。使用 URL 发现时,您可以选择包含或排除与指定路径和模式匹配的页面。
URL 筛选Support精确匹配、前缀匹配和通配符模式。您输入的模式决定了同步是包含还是排除单个 URL、一级路径或多级网站结构。下图显示了网络抓取程序设置流程中的 URL 发现页面,您可以在其中配置 URL 筛选,以包含或排除特定网页。
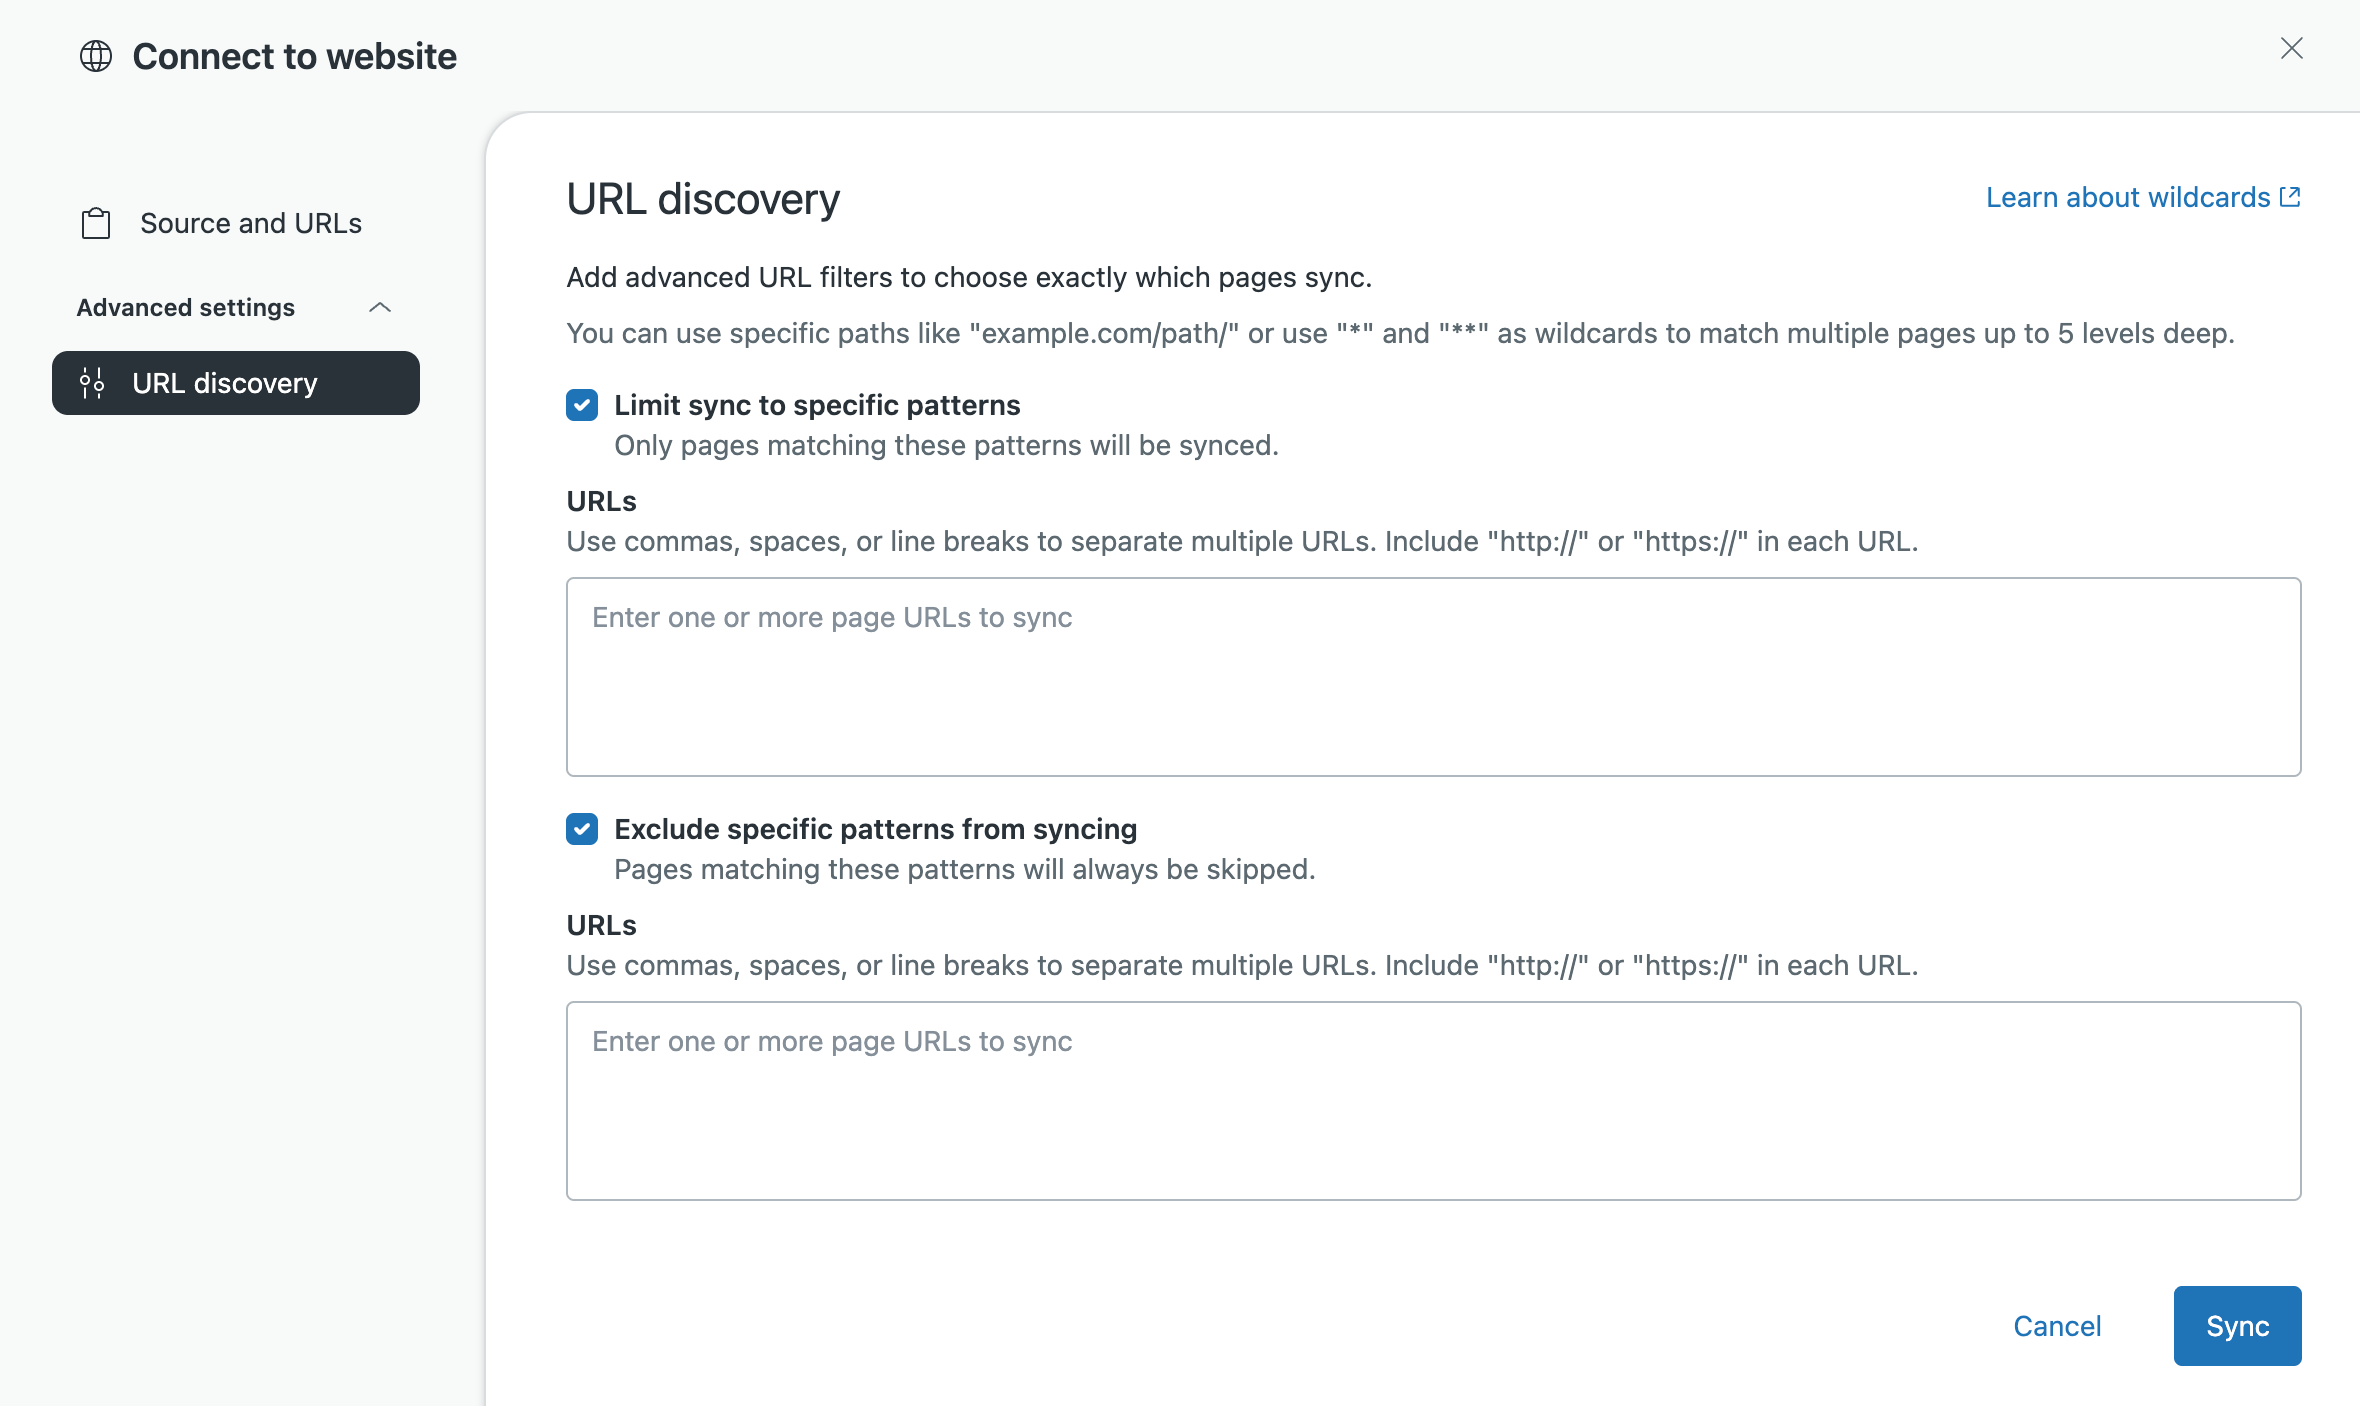
相同模式的行为可能有所不同,具体取决于您将其用作包含还是排除筛选。例如,如果您使用https://example.com/solutions/*作为包含筛选,下一级页面/solutions/包括在内,但不包括深层路径。如果您使用相同的模式作为排除筛选,这些一级页面将被排除,但深层路径不会被排除。
如果您排除确切的 URL 或路径,则该排除 URL 下的所有 URL 也将从同步中排除。
创建 URL 筛选时请遵循以下指南:
- 不带通配符和尾部斜杠的精确 URL 仅匹配该特定 URL。
- 不带通配符的尾部斜杠用作该目录下内容的前缀匹配项。
-
*匹配单个路径或域名段中的字符,不交叉/。 -
**跨路径段的匹配项,包括/。 - 通配符模式可用于包含和排除筛选。
- 在诸如
/path/**/docs,**需要至少一个中间区段,因此/path/docs不匹配。
- 代码会在处理前去除 URL 中的空格
- 非百分比编码的 Unicode URL 被标为格式错误
- 在 robots.txt 规则之前应用 URL 筛选
- 在筛选评估之前,域名外的 URL 将被静默删除
- 模式(全局)匹配区分大小写
常见 URL 筛选模式
下表说明了常见的 URL 筛选模式及其匹配项。
| 模式 | 含义 | 匹配 | 不匹配 |
|---|---|---|---|
| https://example.com/solutions | 仅精确 URL 匹配 | https://example.com/solutions | https://example.com/solutions/page1 |
| https://example.com/solutions/ | 匹配该目录下所有内容的前缀 | https://example.com/solutions/、https://example.com/solutions/page1 | https://example.com/solutions |
| https://example.com/solutions/* | 匹配 /solutions/ 以下的一个级别 | https://example.com/solutions/page1、https://example.com/solutions/education | https://example.com/solutions/education/podcasting |
| https://example.com/solutions/** | 匹配 /solutions/ 以下所有级别 | https://example.com/solutions/page1、https://example.com/solutions/education/podcasting | https://example.com/solutions |
| https://example.com/*.html | 仅匹配根路径中的 .html 文件 | https://example.com/page.html, https://example.com/index.html | https://example.com/docs/page.html |
| https://example.com/**/*.html | 匹配根目录下任意深度的 .html 文件 | https://example.com/docs/page.html、https://example.com/a/b/c/index.html | https://example.com/page.html |
| ttps://example.com/path/**/docs | 匹配 /path/ 下任意深度的 /docs | https://example.com/path/foo/docs、https://example.com/path/foo/bar/docs | https://example.com/path/docs |
| https://*.example.com/** | 匹配 example.com 的任意子域名 | https://log.example.com/page、https://shop.example.com/products/item | https://example.com/page |
| https://*.com/** | 匹配任意 .com 域名 | https://example.com/page、https://other.com/docs/guide、https://sub.example.com/page | https://example.org/page |
翻译免责声明:本文章使用自动翻译软件翻译,以便您了解基本内容。 我们已采取合理措施提供准确翻译,但不保证翻译准确性
如对翻译准确性有任何疑问,请以文章的英语版本为准。