Résumé ◀▼
Utilisez le crawler Web pour indexer le contenu externe public pour la recherche du centre d’aide et les connaissances des agents, sans aucune aide des développeurs. Vous pouvez explorer la totalité d’un site ou des URL spécifiques, appliquer des filtres d’URL, exécuter plusieurs crawlers et maintenir la recherche de contenu par source. Le crawler prend en charge l’exploration adaptative pour le contenu JavaScript, suit uniquement les liens internes et peut conserver les résultats précédents en cas d’échec d’une synchronisation.
Le crawler Web vous permet d’explorer et d’indexer le contenu externe à utiliser là où vous utilisez du contenu externe dans votre compte Zendesk sans ressources pour les développeurs. Vous pouvez configurer plusieurs crawlers pour explorer et indexer différents contenus dans un ou plusieurs sites Web. Vous pouvez aussi explorer une liste d’URL spécifique, sans explorer la totalité du site.
Quand un utilisateur effectue une recherche dans votre centre d’aide, le contenu externe pertinent découvert par le crawler est classé et présenté à la page des résultats de recherche. Sur cette page, l’utilisateur peut filtrer les résultats et cliquer sur les liens pour consulter le lien du contenu externe dans un autre onglet du navigateur.
À propos du crawler Web
Vous pouvez créer un maximum de 50 crawlers Web pour explorer et indexer du contenu externe dans un ou plusieurs sites Web. Le contenu des sites Web explorés et des pages de ces sites est disponible là où vous utilisez du contenu externe dans votre compte Zendesk. Les sites externes que vous voulez explorer doivent être publics (non authentifiés).
- Explorer la totalité du site, le crawler détecte automatiquement les liens à partir des URL de départ configurées, puis les utilise pour explorer toutes les pages de ce site.
- Limiter l’exploration à certaines pages individuelles, vous pouvez spécifier jusqu’à 500 URL que vous voulez explorer. L’option Synchroniser uniquement les URL spécifiées est automatiquement sélectionnée si vous saisissez plus d’une URL. Cependant, si vous ne saisissez qu’une URL de départ, vous pouvez malgré tout sélectionner cette option manuellement pour limiter l’exploration à une seule page. Si vous saisissez un plan du site, cette option est désélectionnée et désactivée, car le crawler doit explorer toutes les pages du plan du site.
Quand vous créez un nouveau crawler, le nom que vous affectez au crawler sera utilisé pour créer la valeur Source. Les valeurs Source sont utilisées comme filtres dans la recherche de votre centre d’aide. Si vous voulez modifier le nom plus tard, vous pouvez toujours modifier ou affecter un autre nom de source. Consultez Gestion des crawlers Web.
Vous pouvez utiliser une seule configuration de crawler ou configurer des paramètres avancés qui vous permettent de créer des filtres d’URL pour affiner la configuration de votre crawler. Vous pouvez créer des filtres d’URL qui inclut ou exclut des URL spécifiques en fonction de schémas avec caractères génériques spécifiques. Consultez Création de filtres d’URL pour limiter la synchronisation des sites Web.
Une fois le crawler configuré, il s’exécute périodiquement. Si un plan du site est accepté comme entrée de l’URL de départ, le crawler suit les instructions de ce plan. Sinon, le crawler détecte automatiquement les liens en suivant les liens de la page de niveau supérieur pour accéder aux pages secondaires et ingérer leur contenu. Le crawler continue de cette manière, en consultant chaque page liée, puis en suivant les liens vers la page suivante dans la hiérarchie du site, jusqu’à ce que le crawler ait exploré la totalité du contenu lié sur quatre niveaux ou la totalité du site, selon la première de ces éventualités. Le crawler suit uniquement les liens qui dirigent vers des pages au sein du domaine du site et n’explore pas les pages externes.
Les crawlers Web indexent le contenu qui se trouve dans la page source au chargement initial de la page, même s’il est masqué par un élément de l’interface, comme un accordéon. Les crawlers peuvent également recourir à l’exploration adaptative pour extraire le contenu dont l’affichage nécessite l’exécution de JavaScript. Avant de traiter chaque section d’un site Web, le crawler prélève automatiquement un petit échantillon de pages et compare les résultats obtenus par une requête standard et un rendu complet dans le navigateur. Si le rendu du navigateur capture nettement plus de contenu, le crawler passe en mode navigateur pour cette partie du site. Cela signifie que différentes parties d’un même site Web peuvent être explorées selon différents modes. Par exemple, une section de blog statique peut recourir à une récupération standard, tandis qu’une section d’application dynamique utilise le rendu par le navigateur. Ce processus se déroule automatiquement, sans nécessiter aucune configuration.
Si le crawler n’arrive pas à recueillir d’information à partir d’un site Web pendant une exploration planifiée (si le site Web est indisponible ou s’il y a des problèmes de réseau, par exemple), le centre d’aide conserve les résultats de l’exploration précédente, dans lesquels il sera toujours possible d’effectuer des recherches dans le centre d’aide.
Configuration d’un crawler Web
- Le crawler Web ne fonctionne pas avec les sites Web qui utilisent le code de compression de fichiers gzip. Vous ne verrez pas de résultats de recherche provenant de ces sites.
- Le crawler Web ne respectera pas de délai de recherche (crawl-delay) s’il est défini pour les enregistrements robots.txt d’un site externe.
- Le marqueur changefreq n’affecte aucunement le crawler Web.
Pour configurer le crawler Web
-
Dans Administrateur de Connaissances, cliquez sur Paramètres (
 ) dans la barre latérale.
- Cliquez sur Paramètres de recherche.
- Sous Crawlers, cliquez sur Gérer.
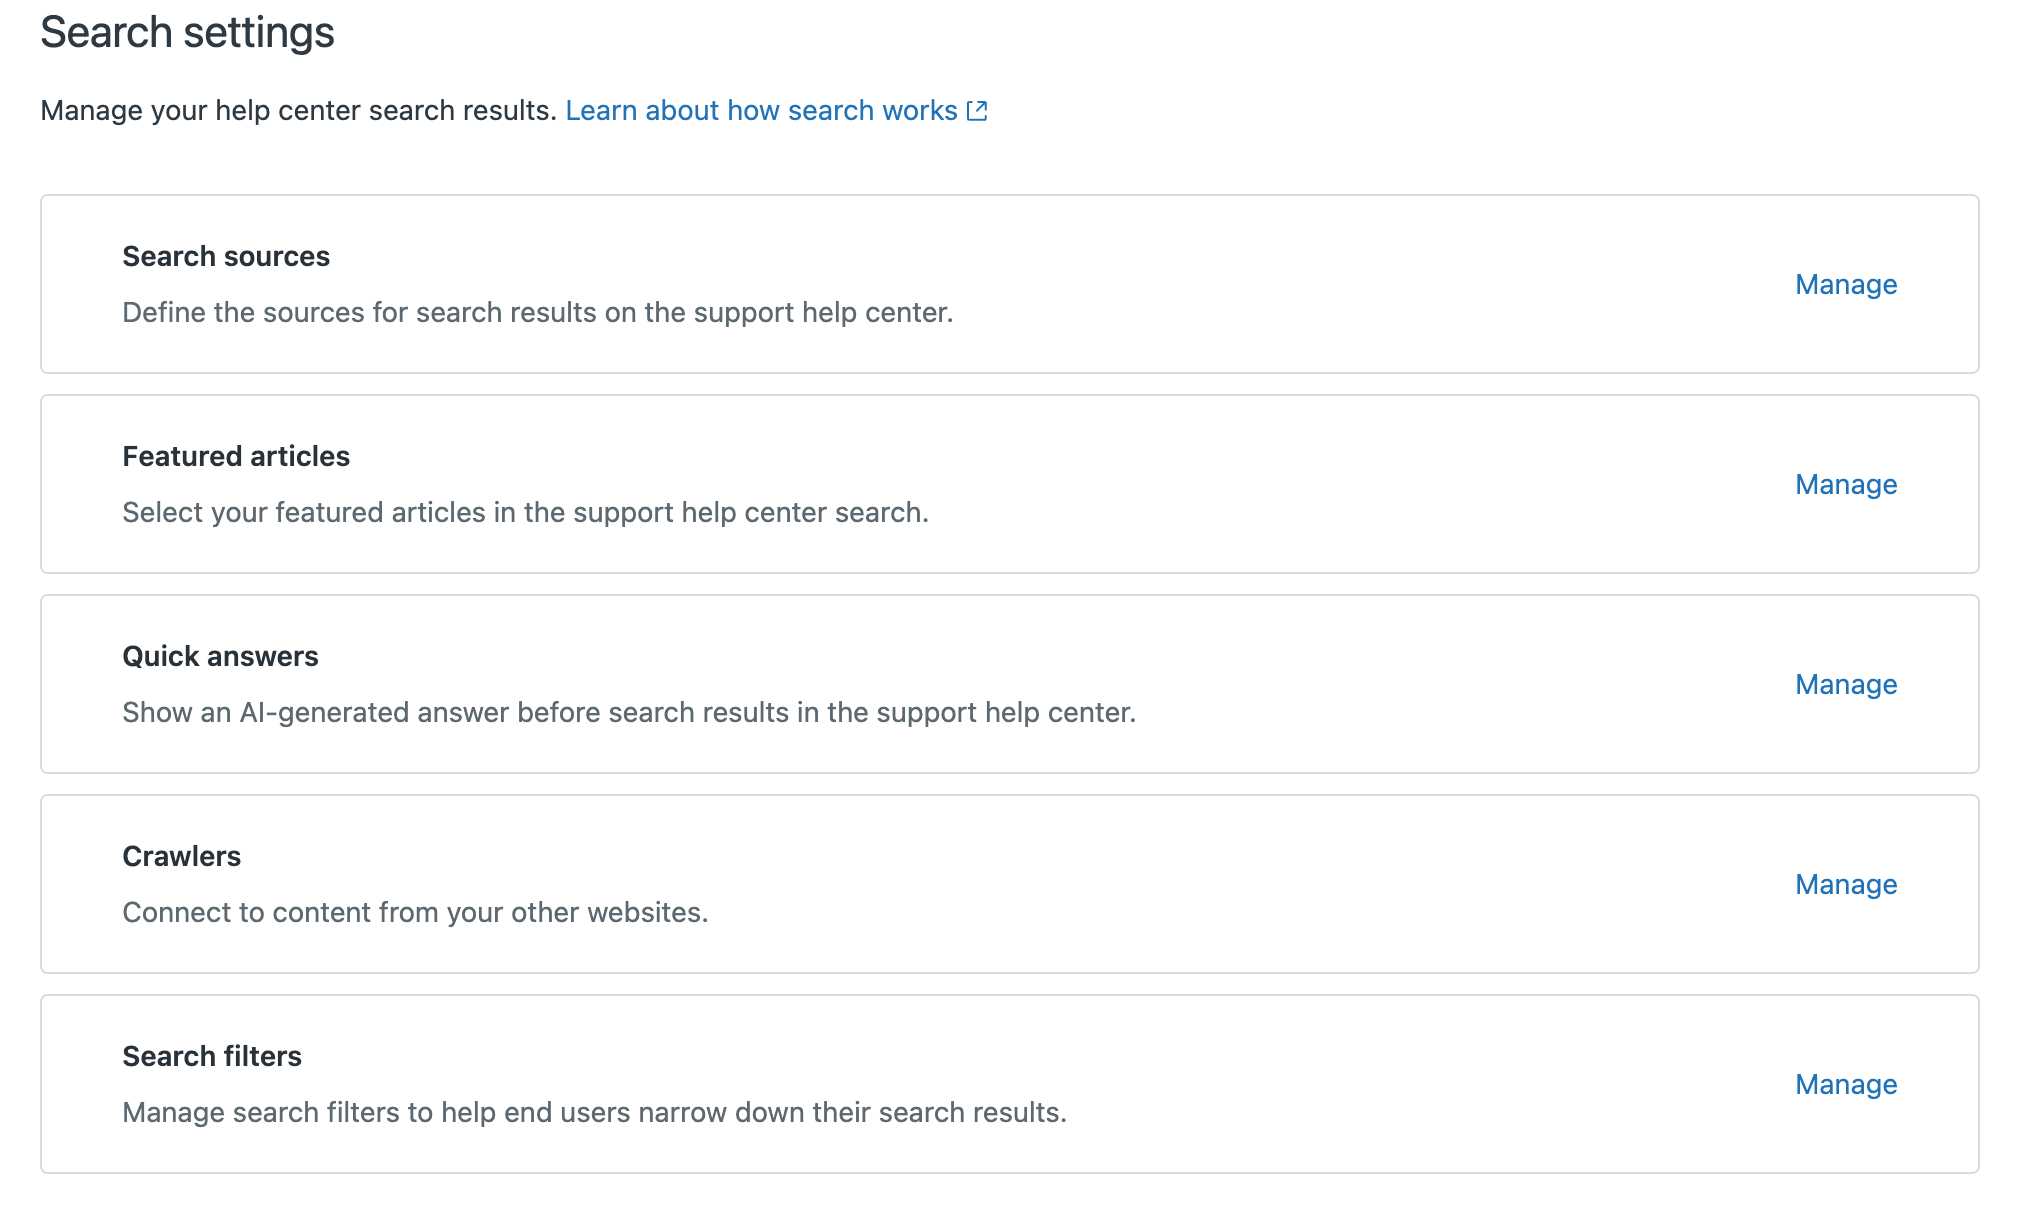
- Cliquez sur Ajouter un crawler.

- Cliquez sur Continuer.
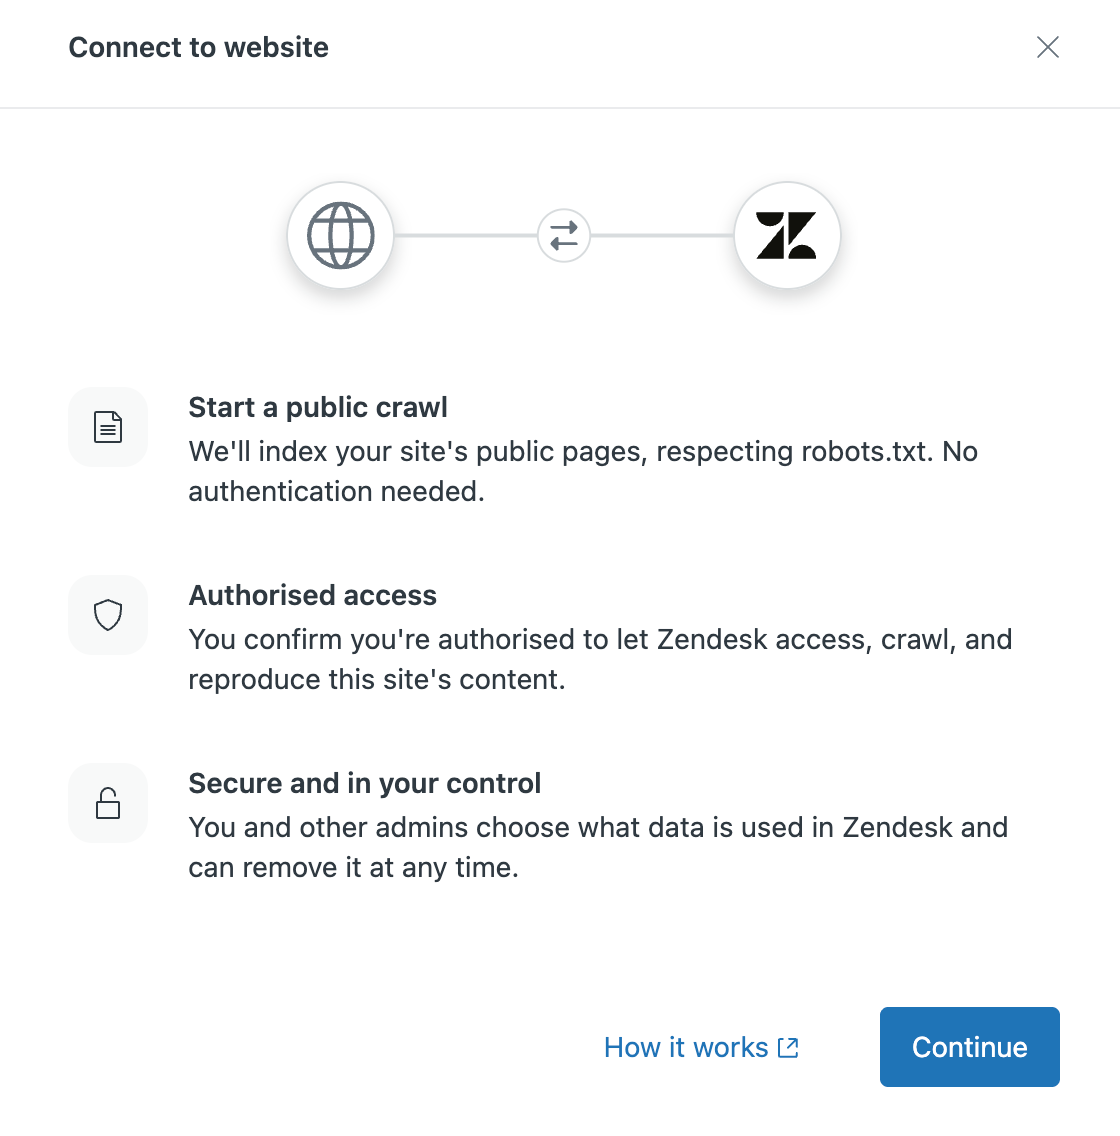
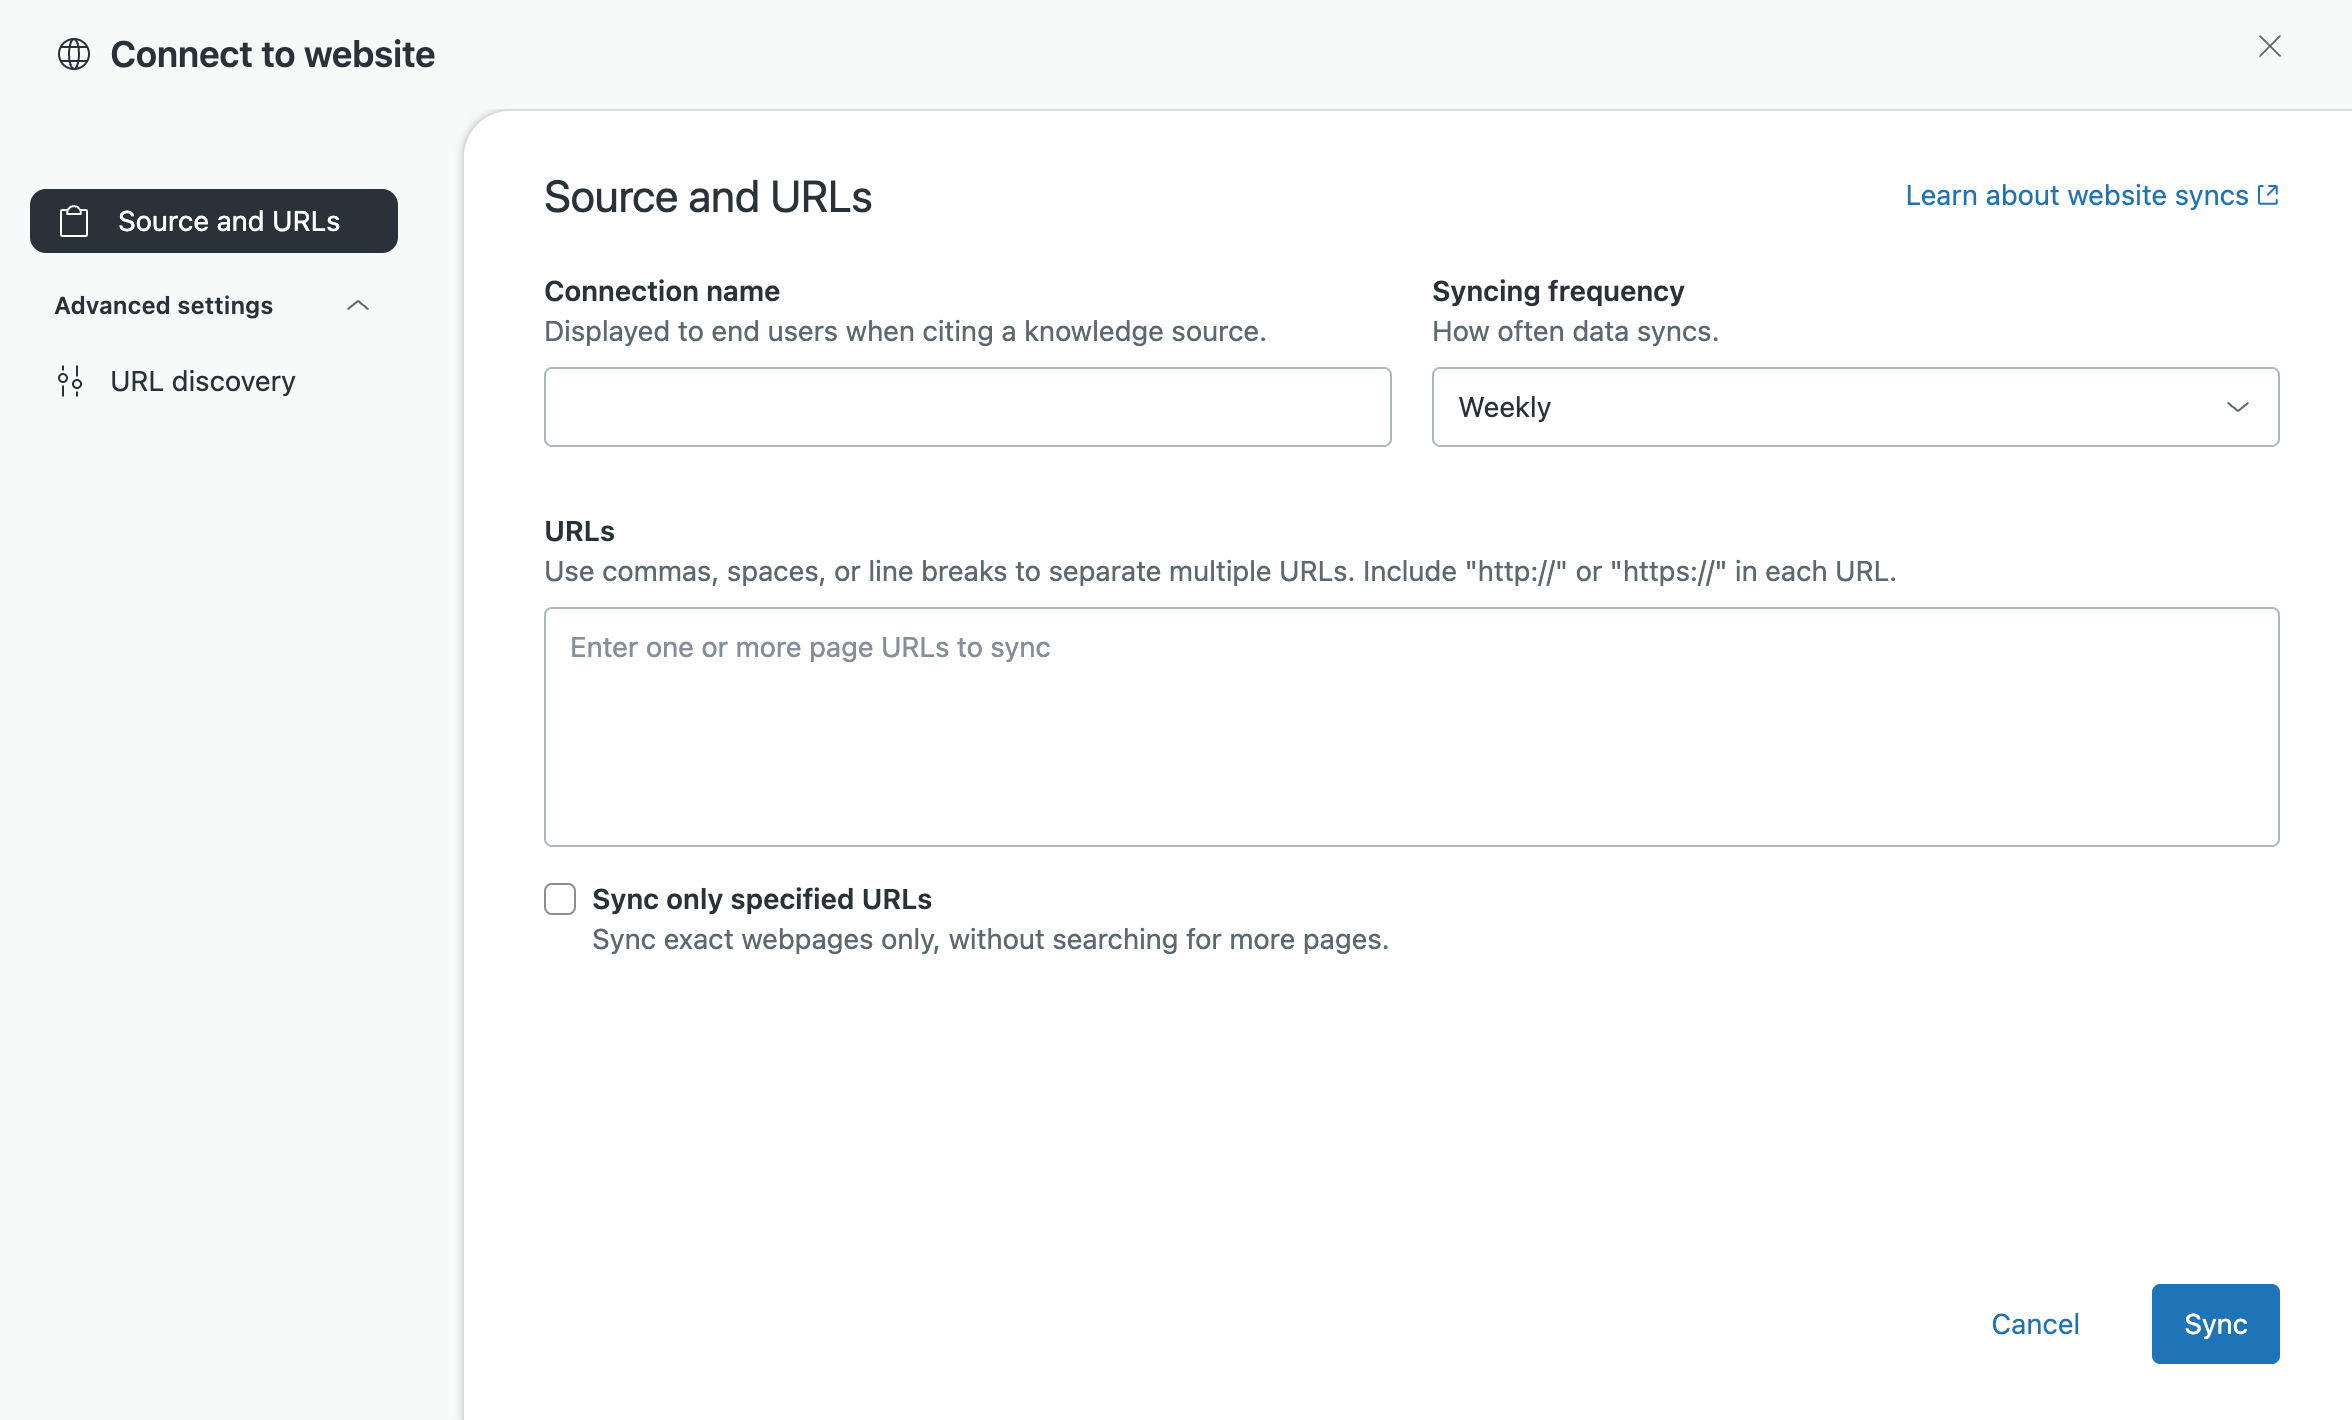
- Dans l’onglet Source et URL, configurez les paramètres suivants :
- Nom de la connexion : identifie votre crawler Web ou la liste de gestion des crawlers, et est utilisé pour créer la valeur de la source de recherche utilisée comme filtre dans la recherche de votre centre d’aide.
- Fréquence de synchronisation : intervalle auquel le crawler Web s’exécute et synchronise les données avec votre compte Zendesk. Vous pouvez accepter le paramètre Hebdomadaire par défaut, ou sélectionner Jamais (pour une synchronisation unique), Quotidienne ou Mensuelle.
- Configurez les options suivantes pour spécifier les pages que vous voulez explorer :
- URL : saisissez les URL des domaines/pages que vous voulez explorer (par exemple, test.com/faq.htm). Vous pouvez saisir un maximum de 500 URL dans ce champ.
-
Synchroniser uniquement les URL spécifiées : spécifiez si vous voulez uniquement explorer les URL que vous avez spécifiées ou toutes les URL au sein des pages spécifiées.
- Cochez la case si vous voulez uniquement explorer les URL que vous avez saisies. Par exemple, si vous avez saisi exemple.com dans le champ d’URL et si vous cochez cette case, le crawler n’explorera et n’indexera que la page exemple.com.
- Décochez la case si vous voulez explorer toutes les pages liées aux URL que vous avez saisies. Par exemple, si vous avez saisi exemple.com dans le champ d’URL et que vous ne cochez pas cette case, le crawler explorera et indexera la page exemple.com et toutes les pages liées au sein de cette page.
- (facultatif) Pour ajouter des filtres d’URL qui inclut ou exclut des URL spécifiques en fonction de schémas avec caractères génériques spécifiques.
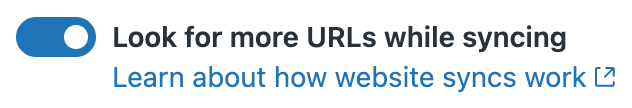
- Cliquez sur l’onglet Paramètres avancés et activez Rechercher plus d’URL pendant la synchronisation.
 Remarque – Pour en savoir plus sur les filtres d’URL et leur création, consultez Création de filtres d’URL pour limiter la synchronisation des sites Web.
-
Si vous voulez uniquement explorer les pages qui :
- Correspondent aux schémas avec caractères génériques que vous créez, sélectionnez Limiter la synchronisation à des schémas spécifiques et ajoutez les schémas que vous voulez synchroniser, puis saisissez les URL et les caractères génériques que vous voulez inclure dans le champ URL.
- Ne correspondent pas aux schémas avec caractères génériques que vous créez, sélectionnez Exclure des schémas spécifiques de la synchronisation et saisissez les URL et les caractères génériques que vous voulez exclure dans le champ URL.
- Cliquez sur l’onglet Paramètres avancés et activez Rechercher plus d’URL pendant la synchronisation.
- Consultez la bannière de résumé pour vérifier vos paramètres et les modifier si besoin est.
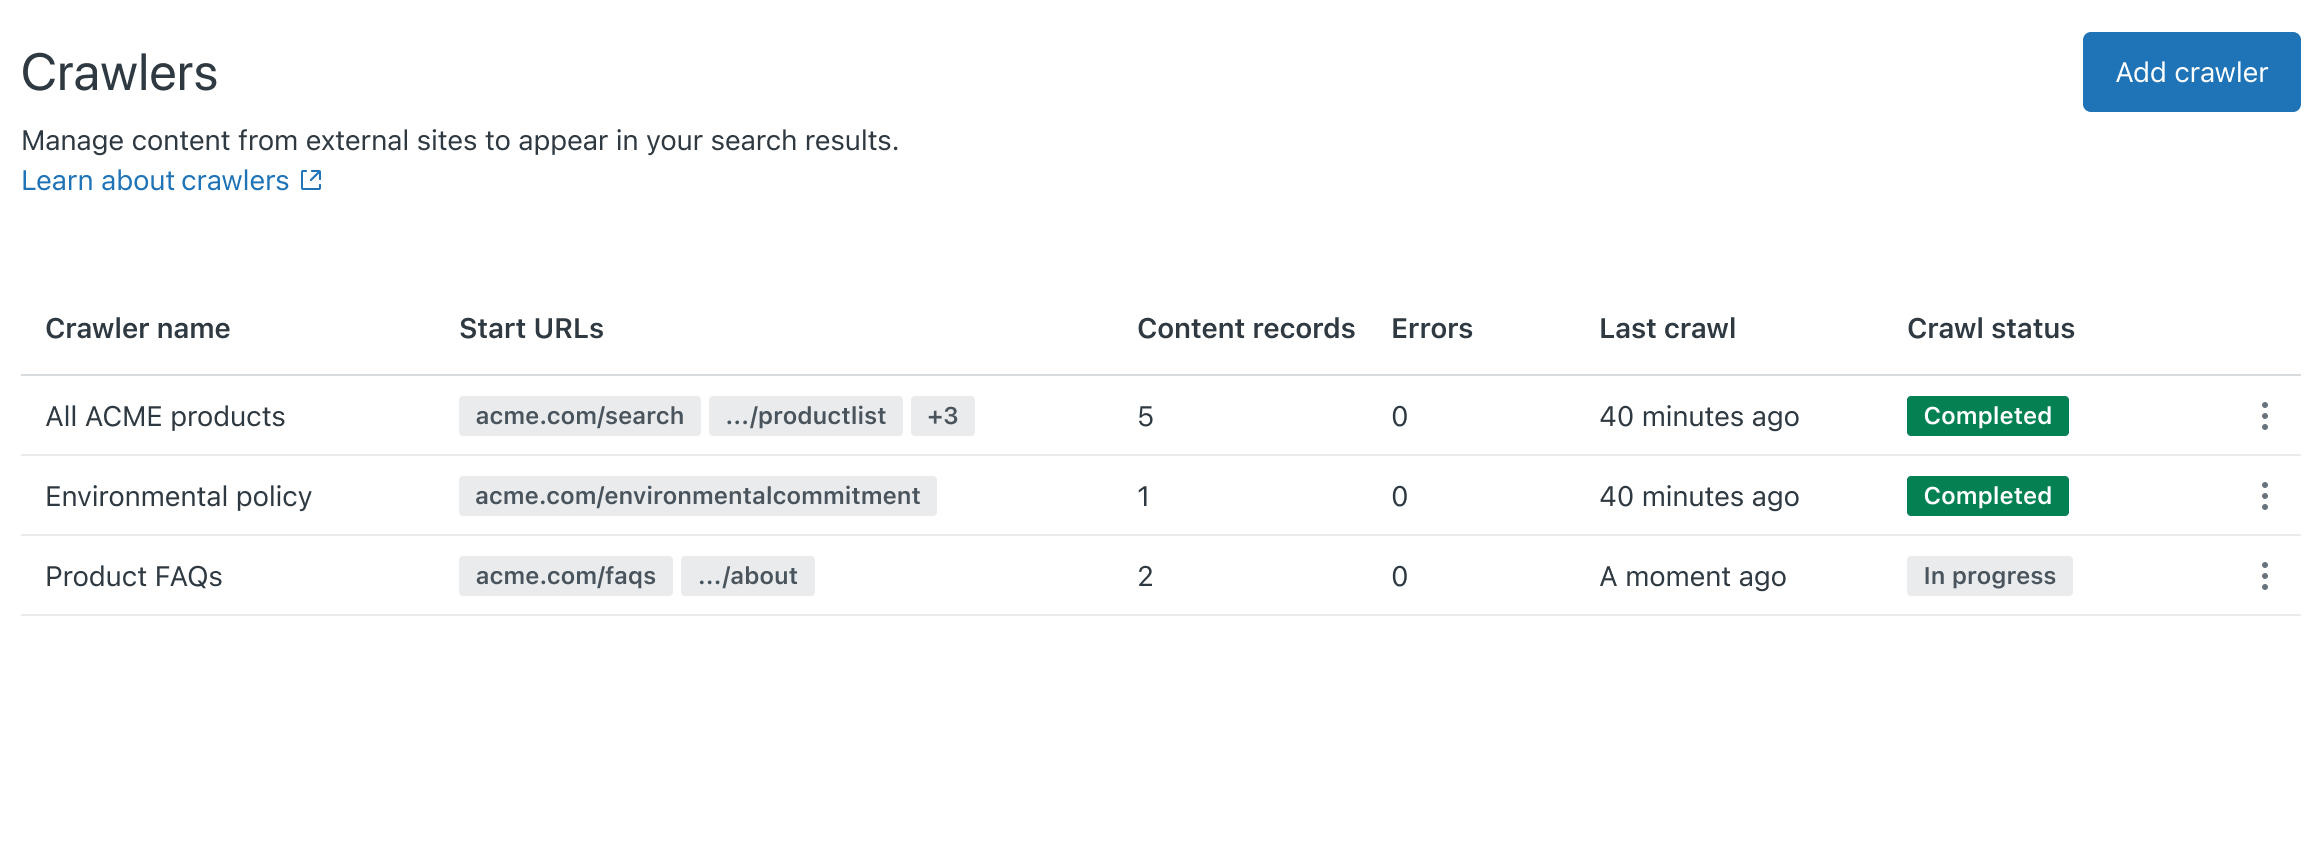
- Cliquez sur Synchroniser. Le crawler Web est ajouté à la page Crawlers et commence à explorer les pages et à indexer leur contenu. Le crawler s’exécute à l’intervalle défini dans le champ de fréquence de synchronisation (voir l’étape 6 ci-dessus). Si le crawler échoue, le propriétaire du crawler recevra une notification par e-mail avec des conseils de dépannage pour l’aider à résoudre le problème. Le crawler réessaiera à intervalles réguliers.Remarque – Zendesk/External-Content est l’agent utilisateur pour le crawler Web. Pour éviter qu’un crawler n’échoue à cause d’un pare-feu bloquant les demandes, ajoutez Zendesk/External-Content à votre liste autorisée.
- La recherche du centre d’aide : vous devez sélectionner le contenu à inclure et à exclure des résultats de recherche de votre centre d’aide. Consultez Inclusion du contenu externe dans les résultats de recherche de votre centre d’aide.
- La section Connaissances du volet contextuel pour les agents : consultez Configuration de la section Connaissances.