Riepilogo: ◀▼
I filtri URL consentono di limitare la sincronizzazione del web crawler includendo o escludendo pagine specifiche con URL esatti, corrispondenze di prefissi e modelli di caratteri jolly. Puoi evitare di sincronizzare i contenuti riservati agli amministratori o ai dipendenti, controllare i percorsi di cui eseguire la scansione e ridurre la configurazione manuale. L’articolo spiega come funzionano le regole di inclusione ed esclusione, oltre a esempi di modelli comuni come corrispondenze a livello singolo, multilivello e sottodominio.
Quando configuri un web crawler, puoi scegliere di configurare impostazioni avanzate che ti consentono di perfezionare la sincronizzazione aggiungendo filtri URL. I filtri URL consentono di usare modelli di caratteri jolly per definire percorsi specifici che restringono l’ambito della sincronizzazione di un sito web.
Invece di sincronizzare tutto in un punto di partenza ampio, puoi definire quali URL devono essere inclusi e quali devono essere esclusi. Puoi usare URL esatti, corrispondenze di prefissi e modelli di caratteri jolly per restringere l’ambito della sincronizzazione, il che aiuta a ridurre la configurazione manuale ed evitare la sincronizzazione di pagine non pertinenti come le sezioni riservate agli amministratori o ai dipendenti.
- I filtri di esclusione vengono valutati per primi. Se un URL corrisponde a un filtro di esclusione, verrà rifiutato, anche se corrisponde a un filtro di inclusione.
- I filtri Includi agiscono come un elenco consentito quando specificati
- Se non sono configurati filtri, tutti gli URL sono consentiti.
Informazioni sui modelli di filtro URL
Quando configuri un web crawler, puoi usare la scheda di individuazione URL facoltativa nel flusso di configurazione per definire filtri URL che usano caratteri jolly per specificare le pagine esatte da sincronizzare. Quando usi il rilevamento degli URL, puoi scegliere di includere o escludere le pagine che corrispondono ai percorsi e ai modelli specificati.
I filtri URL assistenza le corrispondenze esatte, le corrispondenze dei prefissi e i modelli con caratteri jolly. Il modello inserito determina se la sincronizzazione include o esclude un singolo URL, un livello di un percorso o più livelli della struttura di un sito. L’immagine seguente mostra la pagina di individuazione degli URL nel flusso di configurazione del web crawler, in cui è possibile configurare i filtri URL che includeranno o escluderanno pagine web specifiche.
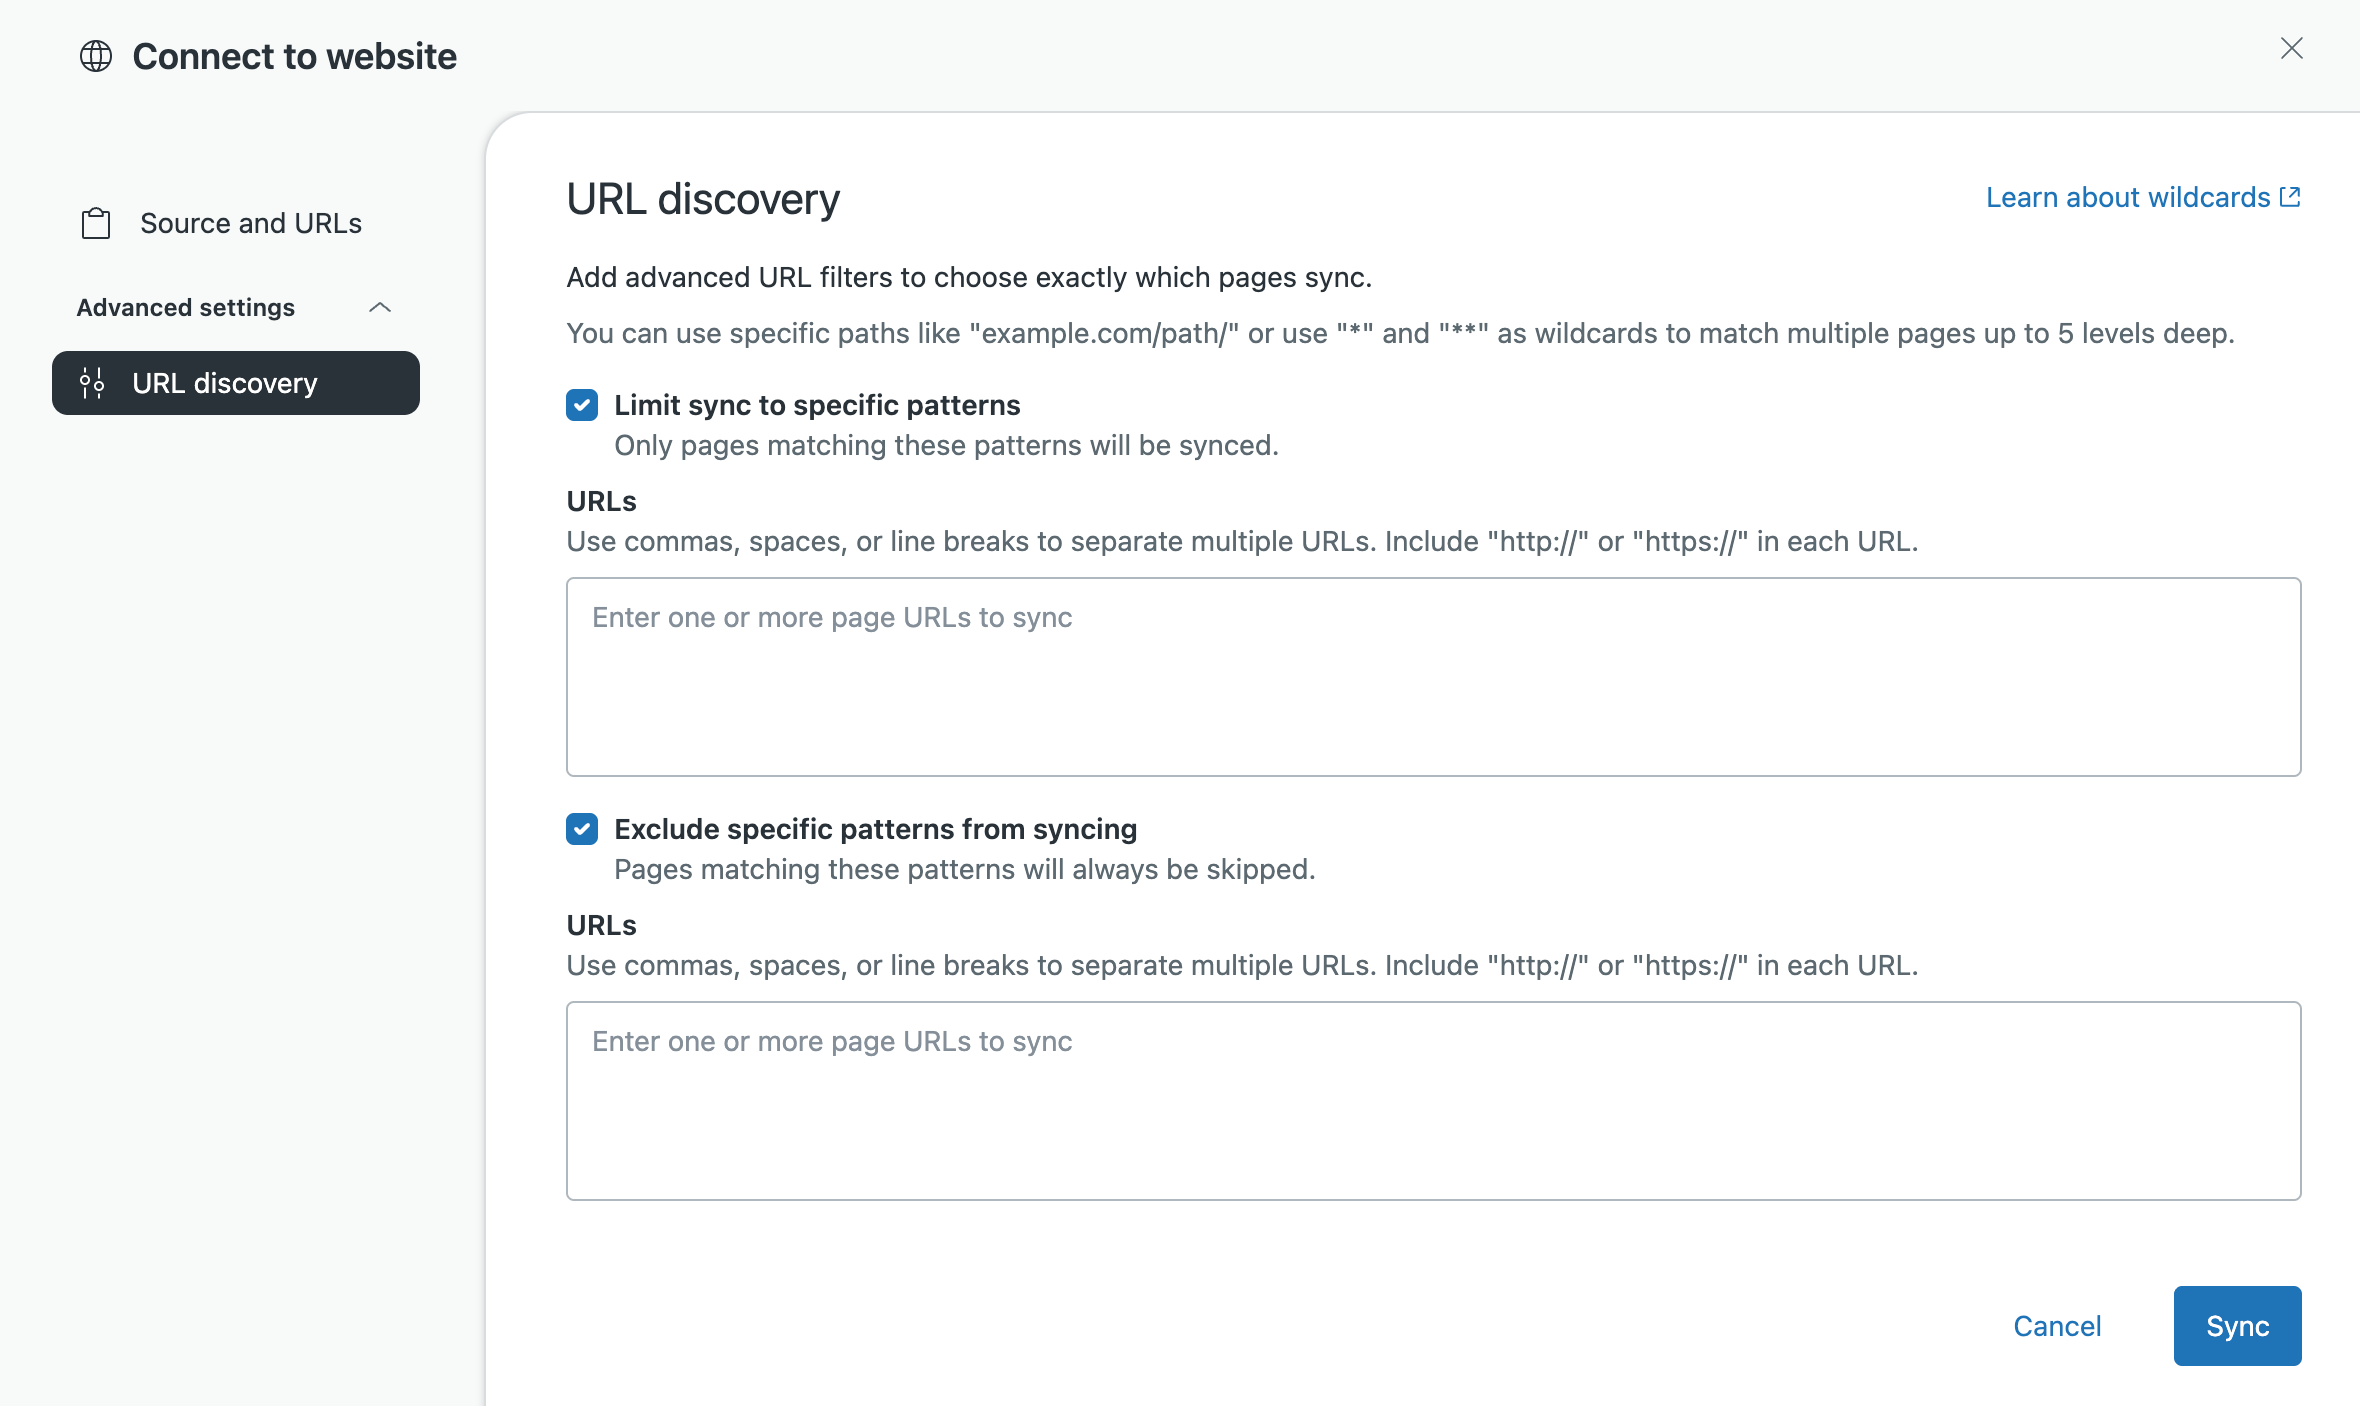
Lo stesso modello può comportarsi in modo diverso a seconda che venga usato come filtro di inclusione o esclusione. Ad esempio, se usihttps://example.com/solutions/* come filtro di inclusione, pagine di un livello inferiore/solutions/ sono inclusi, ma i percorsi più profondi no. Se usi lo stesso modello di un filtro di esclusione, quelle pagine a un livello vengono escluse, ma non i percorsi più profondi.
Se escludi un URL o un percorso esatto, anche tutti gli URL al di sotto di tale URL escluso vengono esclusi dalla sincronizzazione.
Segui le linee guida seguenti quando crei i filtri URL:
- Un URL esatto senza caratteri jolly e senza barra finale corrisponde solo a quell’URL specifico.
- Una barra finale senza caratteri jolly funge da corrispondenza del prefisso per il contenuto in quella directory.
-
*corrisponde ai caratteri all’interno di un singolo percorso o segmento di dominio e non incrocia/. -
**corrisponde a tutti i segmenti di percorso, inclusi/. - I modelli con caratteri jolly possono essere usati sia nei filtri di inclusione che in quelli di esclusione.
- In modelli come
/path/**/docs,**richiede almeno un segmento intermedio, quindi/path/docsnon corrisponde.
- Il codice rimuove gli spazi vuoti dagli URL prima dell’elaborazione
- Gli URL Unicode non codificati in percentuale sono contrassegnati come non validi
- I filtri URL vengono applicati prima delle regole robots.txt
- Gli URL al di fuori del dominio vengono eliminati automaticamente prima della valutazione del filtro
- La corrispondenza del modello (glob) fa distinzione tra maiuscole e minuscole
Modelli di filtro URL comuni
La tabella seguente illustra i modelli di filtro URL comuni e le relative corrispondenze.
| Modello | Significato | Corrisponde a | Non corrisponde a |
|---|---|---|---|
| https://esempio.com/solutions | Solo corrispondenza URL esatta | https://esempio.com/solutions | https://example.com/solutions/page1 |
| https://esempio.com/solutions/ | Corrispondenza prefisso per qualsiasi cosa in quella directory | https://example.com/solutions/, https://example.com/solutions/page1 | https://esempio.com/solutions |
| https://example.com/solutions/* | Corrisponde a un livello inferiore a /solutions/ | https://example.com/solutions/page1, https://example.com/solutions/education | https://example.com/solutions/education/podcasting |
| https://example.com/solutions/** | Corrisponde a tutti i livelli inferiori a /solutions/ | https://example.com/solutions/page1, https://example.com/solutions/education/podcasting | https://esempio.com/solutions |
| https://esempio.com/*.html | Corrisponde solo ai file .html nel percorso principale | https://example.com/page.html, https://example.com/index.html | https://esempio.com/docs/page.html |
| https://esempio.com/**/*.html | Corrisponde ai file .html sotto la radice a qualsiasi profondità | https://example.com/docs/page.html, https://example.com/a/b/c/index.html | https://example.com/page.html |
| ttps://example.com/path/**/docs | Corrisponde a /docs a qualsiasi livello in /path/ | https://example.com/path/foo/docs, https://example.com/path/foo/bar/docs | https://example.com/path/docs |
| https://*.example.com/** | Corrisponde a qualsiasi sottodominio di esempio.com | https://blog.example.com/page, https://shop.example.com/products/item | https://esempio.com/pagina |
| https://*.com/** | Corrisponde a qualsiasi dominio .com | https://example.com/page, https://other.com/docs/guide, https://sub.example.com/page | https://esempio.org/page |
Avvertenza sulla traduzione: questo articolo è stato tradotto usando un software di traduzione automatizzata per fornire una comprensione di base del contenuto. È stato fatto tutto il possibile per fornire una traduzione accurata, tuttavia Zendesk non garantisce l'accuratezza della traduzione.
Per qualsiasi dubbio sull'accuratezza delle informazioni contenute nell'articolo tradotto, fai riferimento alla versione inglese dell'articolo come versione ufficiale.