Riepilogo: ◀▼
Usa il web crawler per indicizzare i contenuti pubblici esterni per la ricerca centro assistenza e la knowledge degli agenti senza l’aiuto degli sviluppatori. Puoi eseguire la scansione di un intero sito o di URL specifici, applicare filtri URL, eseguire più crawler e mantenere i contenuti ricercabili in base all’origine. Il crawler supporta la scansione adattiva per i contenuti JavaScript, segue solo i link interni e può conservare i risultati precedenti se una sincronizzazione non riesce.
Il web crawler ti consente di eseguire la scansione e l’indicizzazione di contenuti esterni da usare ovunque utilizzi contenuti esterni nel tuo account Zendesk senza risorse per gli sviluppatori. Puoi configurare più crawler per eseguire la scansione e indicizzare contenuti diversi nello stesso sito web o in siti web diversi. Puoi anche eseguire la scansione di un elenco di URL specifici senza dover eseguire la scansione di un intero sito.
Quando gli utenti eseguono una ricerca nel centro assistenza, i contenuti esterni pertinenti individuati dal crawler vengono classificati e presentati nella pagina dei risultati della ricerca, dove gli utenti possono filtrare i risultati e fare clic sui link per visualizzare i contenuti esterni in un'altra scheda del browser.
Informazioni sul web crawler
Puoi creare fino a 50 web crawler per eseguire la scansione e indicizzare contenuti esterni nello stesso sito web o in siti web diversi. I contenuti dei siti web sottoposti a scansione e le pagine all’interno dei siti web sono disponibili ovunque usi contenuti esterni nel tuo account Zendesk. I siti esterni di cui vuoi eseguire la scansione devono essere pubblici (non autenticati).
- Scansionando l’intero sito , il crawler rileva automaticamente i link dagli URL iniziali configurati e li usa per eseguire la scansione di tutte le pagine del sito.
- Limita la scansione a singole pagine : puoi specificare fino a 500 URL di cui eseguire la scansione. L’opzione Sincronizza solo gli URL specificati viene selezionata automaticamente se inserisci più di un URL. Tuttavia, se inserisci un solo URL iniziale, puoi comunque selezionare manualmente questa opzione per limitare la scansione a una singola pagina. Se inserisci una mappa del sito, questa opzione viene deselezionata e disabilitata, in quanto il crawler deve eseguire la scansione di tutte le pagine della mappa del sito.
Quando crei un nuovo crawler, il nome che assegni al crawler verrà usato per creare il valore di origine. I valori di origine vengono usati come filtri nella ricerca nel centro assistenza. Se vuoi cambiare il nome in un secondo momento, puoi sempre modificare o assegnare un nome di origine diverso. Consulta Gestione dei web crawler.
Puoi usare una semplice configurazione del crawler oppure puoi scegliere di configurare impostazioni avanzate che ti consentono di creare filtri URL che perfezionano la configurazione del crawler. Puoi creare filtri URL che includeranno o escluderanno URL specifici in base a modelli di caratteri jolly specifici. Consulta Creazione di filtri URL per l’ambito delle sincronizzazioni di webstite .
Dopo la configurazione, il crawler viene eseguito periodicamente. Se una mappa del sito viene accettata come input per l’URL iniziale, il crawler segue le istruzioni nella mappa del sito. In caso contrario, il crawler rileva automaticamente i link seguendo i link nella pagina di livello superiore per visitare le pagine secondarie e importarne i contenuti. Il crawler continua in questo modo, visitando ogni pagina collegata e quindi seguendo i link alla pagina successiva nella gerarchia del sito. Questa operazione continua fino a quando il crawler non ha eseguito la scansione di tutti i contenuti collegati a quattro livelli o dell’intero sito, a seconda dell’evento che si verifica per primo. Il crawler segue solo i link che rimandano a pagine all’interno del dominio del sito; non vengono visitate pagine esterne.
I web crawler indicizzano i contenuti che si trovano nell’origine della pagina caricata inizialmente, anche se sono nascosti da un elemento dell’interfaccia utente, come un pannello accordion. I web crawler possono anche usare la scansione adattiva per acquisire contenuti la cui visualizzazione richiede JavaScript. Prima di elaborare ogni sezione di un sito web, il crawler campiona automaticamente un numero limitato di pagine e confronta i risultati tra un recupero standard e un rendering completo del browser. Se il rendering del browser acquisisce una quantità notevolmente maggiore di contenuti, il crawler passa alla modalità browser per quella sezione del sito. Ciò significa che è possibile eseguire la scansione di parti diverse dello stesso sito web in modalità diverse. Ad esempio, una sezione di un blog statico potrebbe usare il recupero standard, mentre una sezione di app dinamica usa il rendering del browser. Questo processo viene eseguito automaticamente senza alcuna configurazione.
Se il crawler non riesce a raccogliere informazioni da un sito web durante una scansione pianificata regolarmente (ad esempio, se il sito web è inattivo o se ci sono problemi di rete), il centro assistenza conserverà i risultati della scansione precedente, che continueranno a essere ricercabili nel centro assistenza.
Configurazione di un web crawler
- Il web crawler non funziona con i siti web che usano la codifica di compressione dei file gzip. Non vedrai i risultati delle ricerche in questi siti.
- Un ritardo di crawl non verrà rispettato dal web crawler se impostato sui record robots.txt del sito esterno.
- Il tag changefreq non influisce in alcun modo sul web crawler.
Per configurare il web crawler
-
In Amministratore Knowledge, fai clic su Impostazioni (
 ) nella barra laterale.
- Fai clic su Impostazioni di ricerca.
- In Crawler, fai clic su Gestisci.
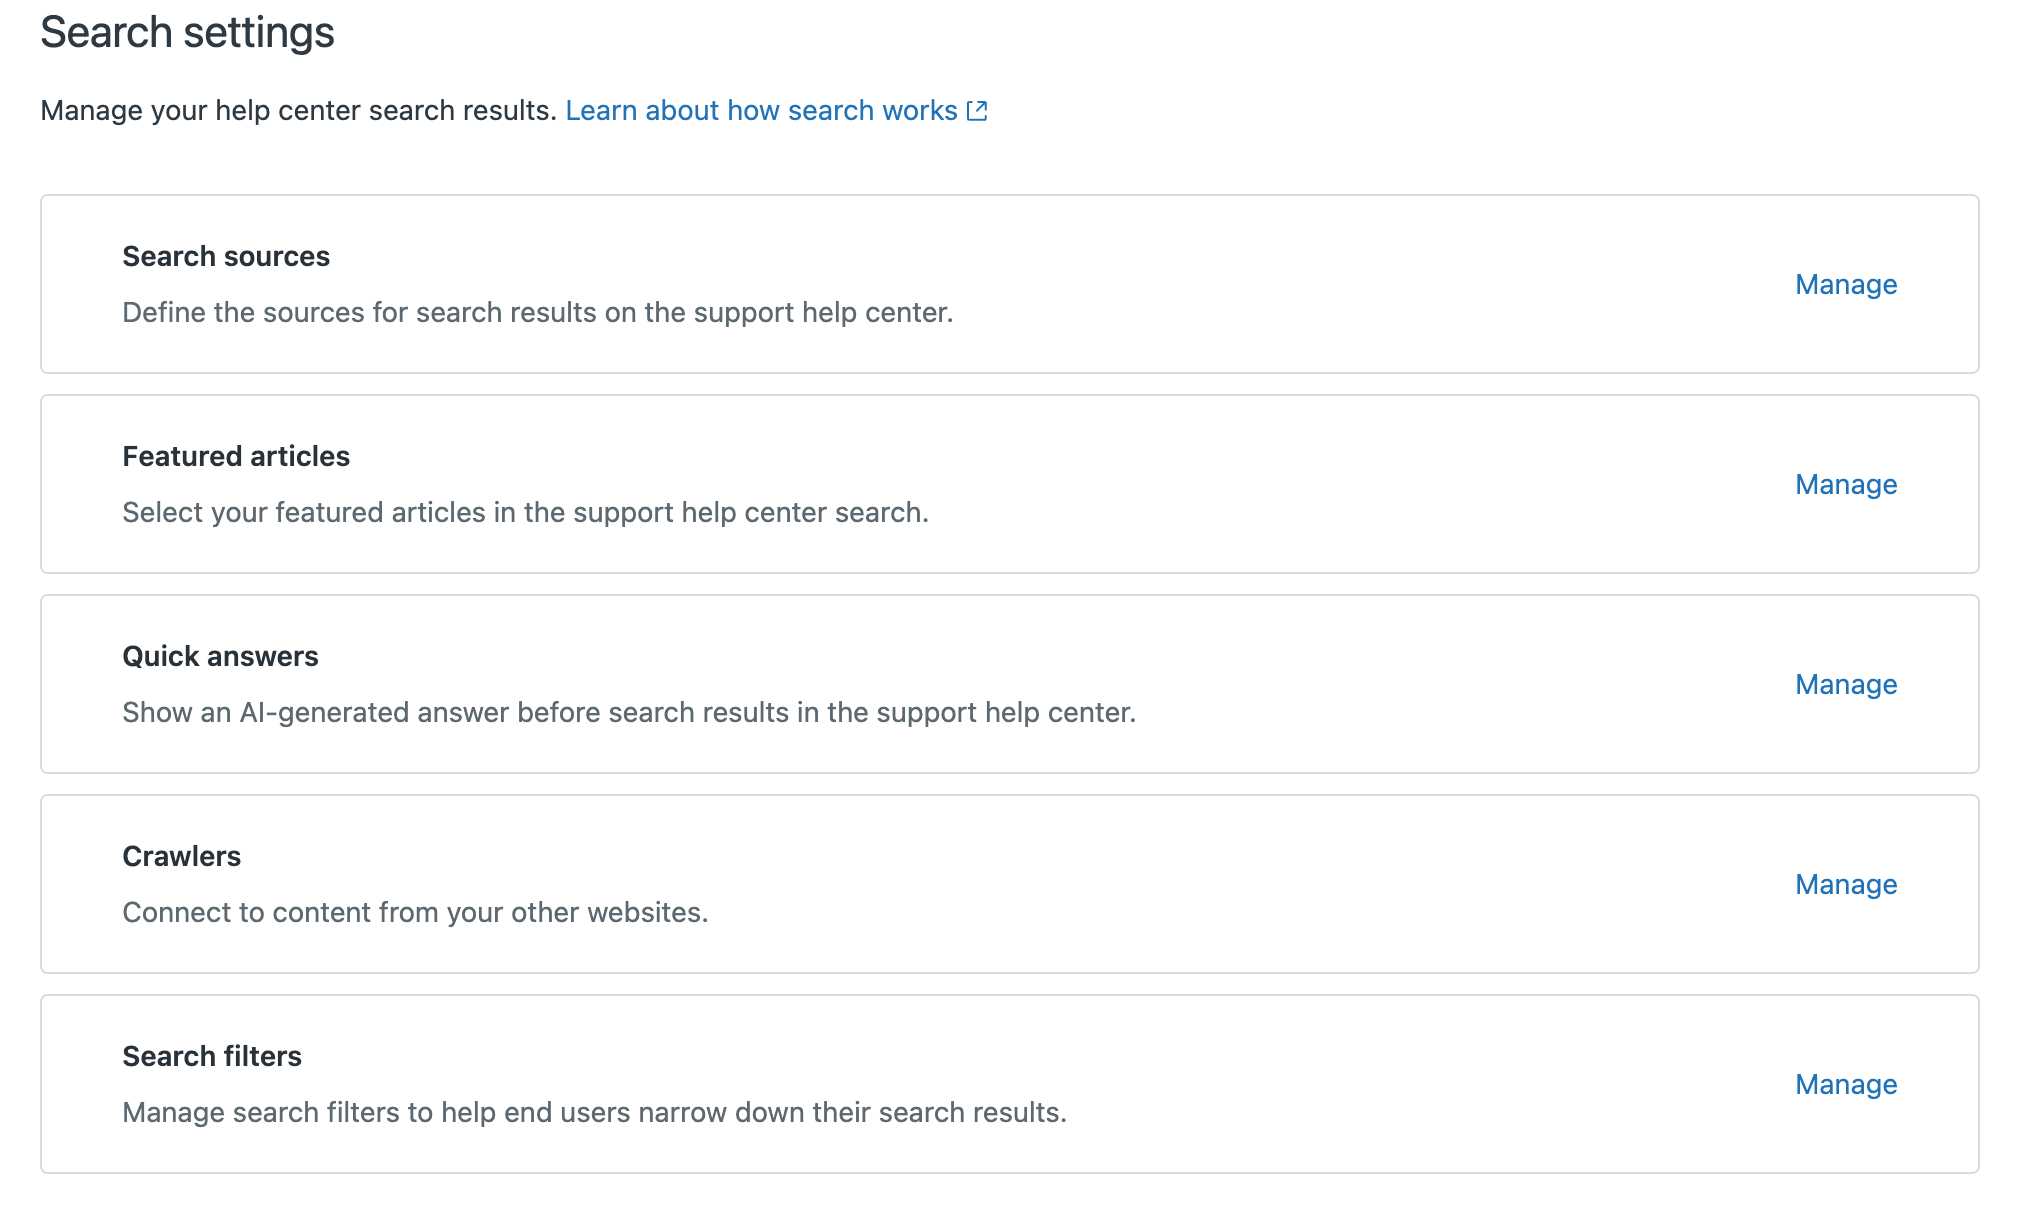
- Fai clic su Aggiungi crawler.

- Fai clic su Continua.
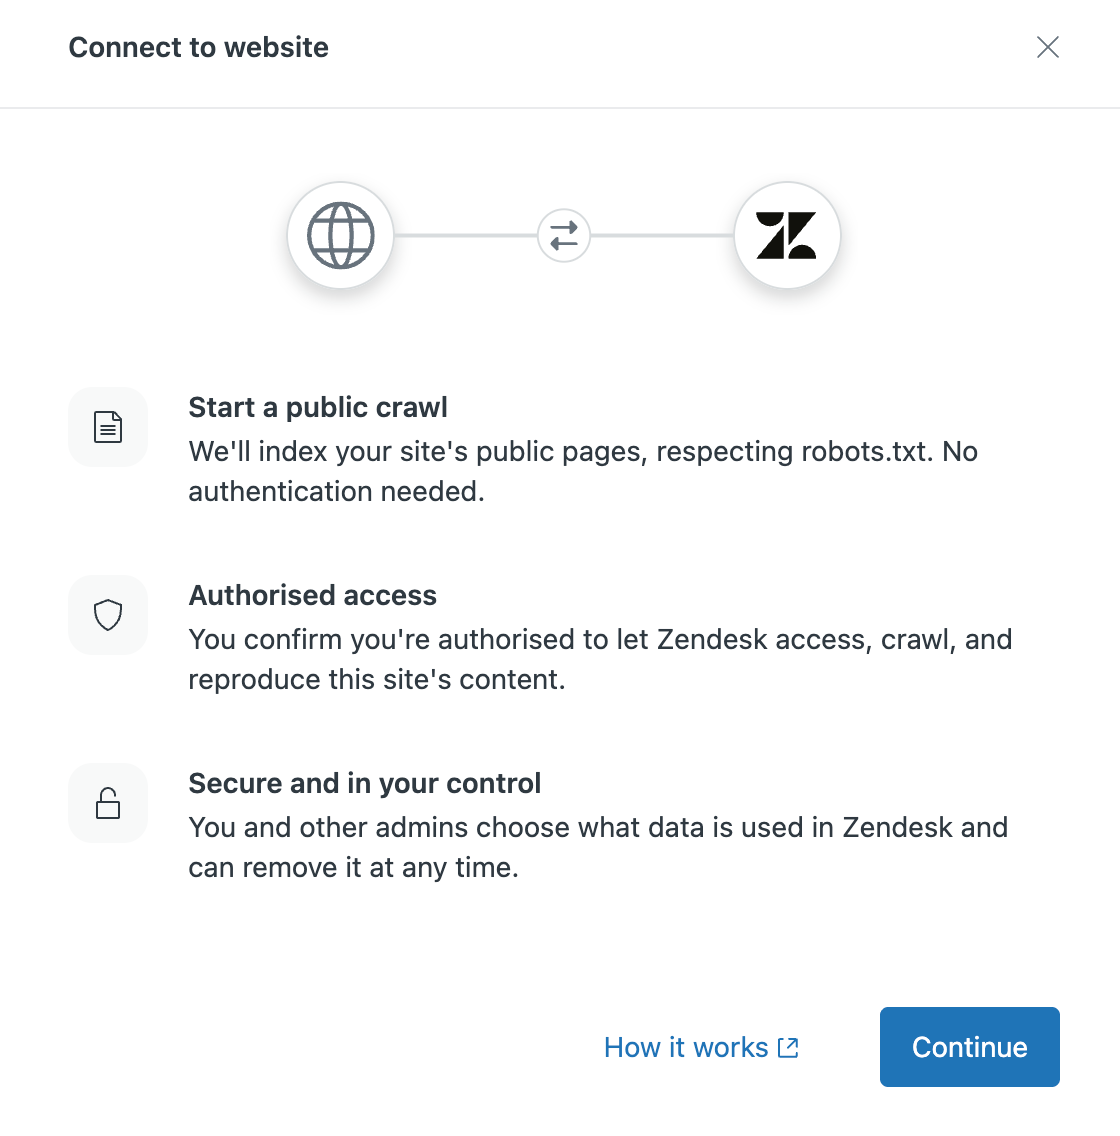
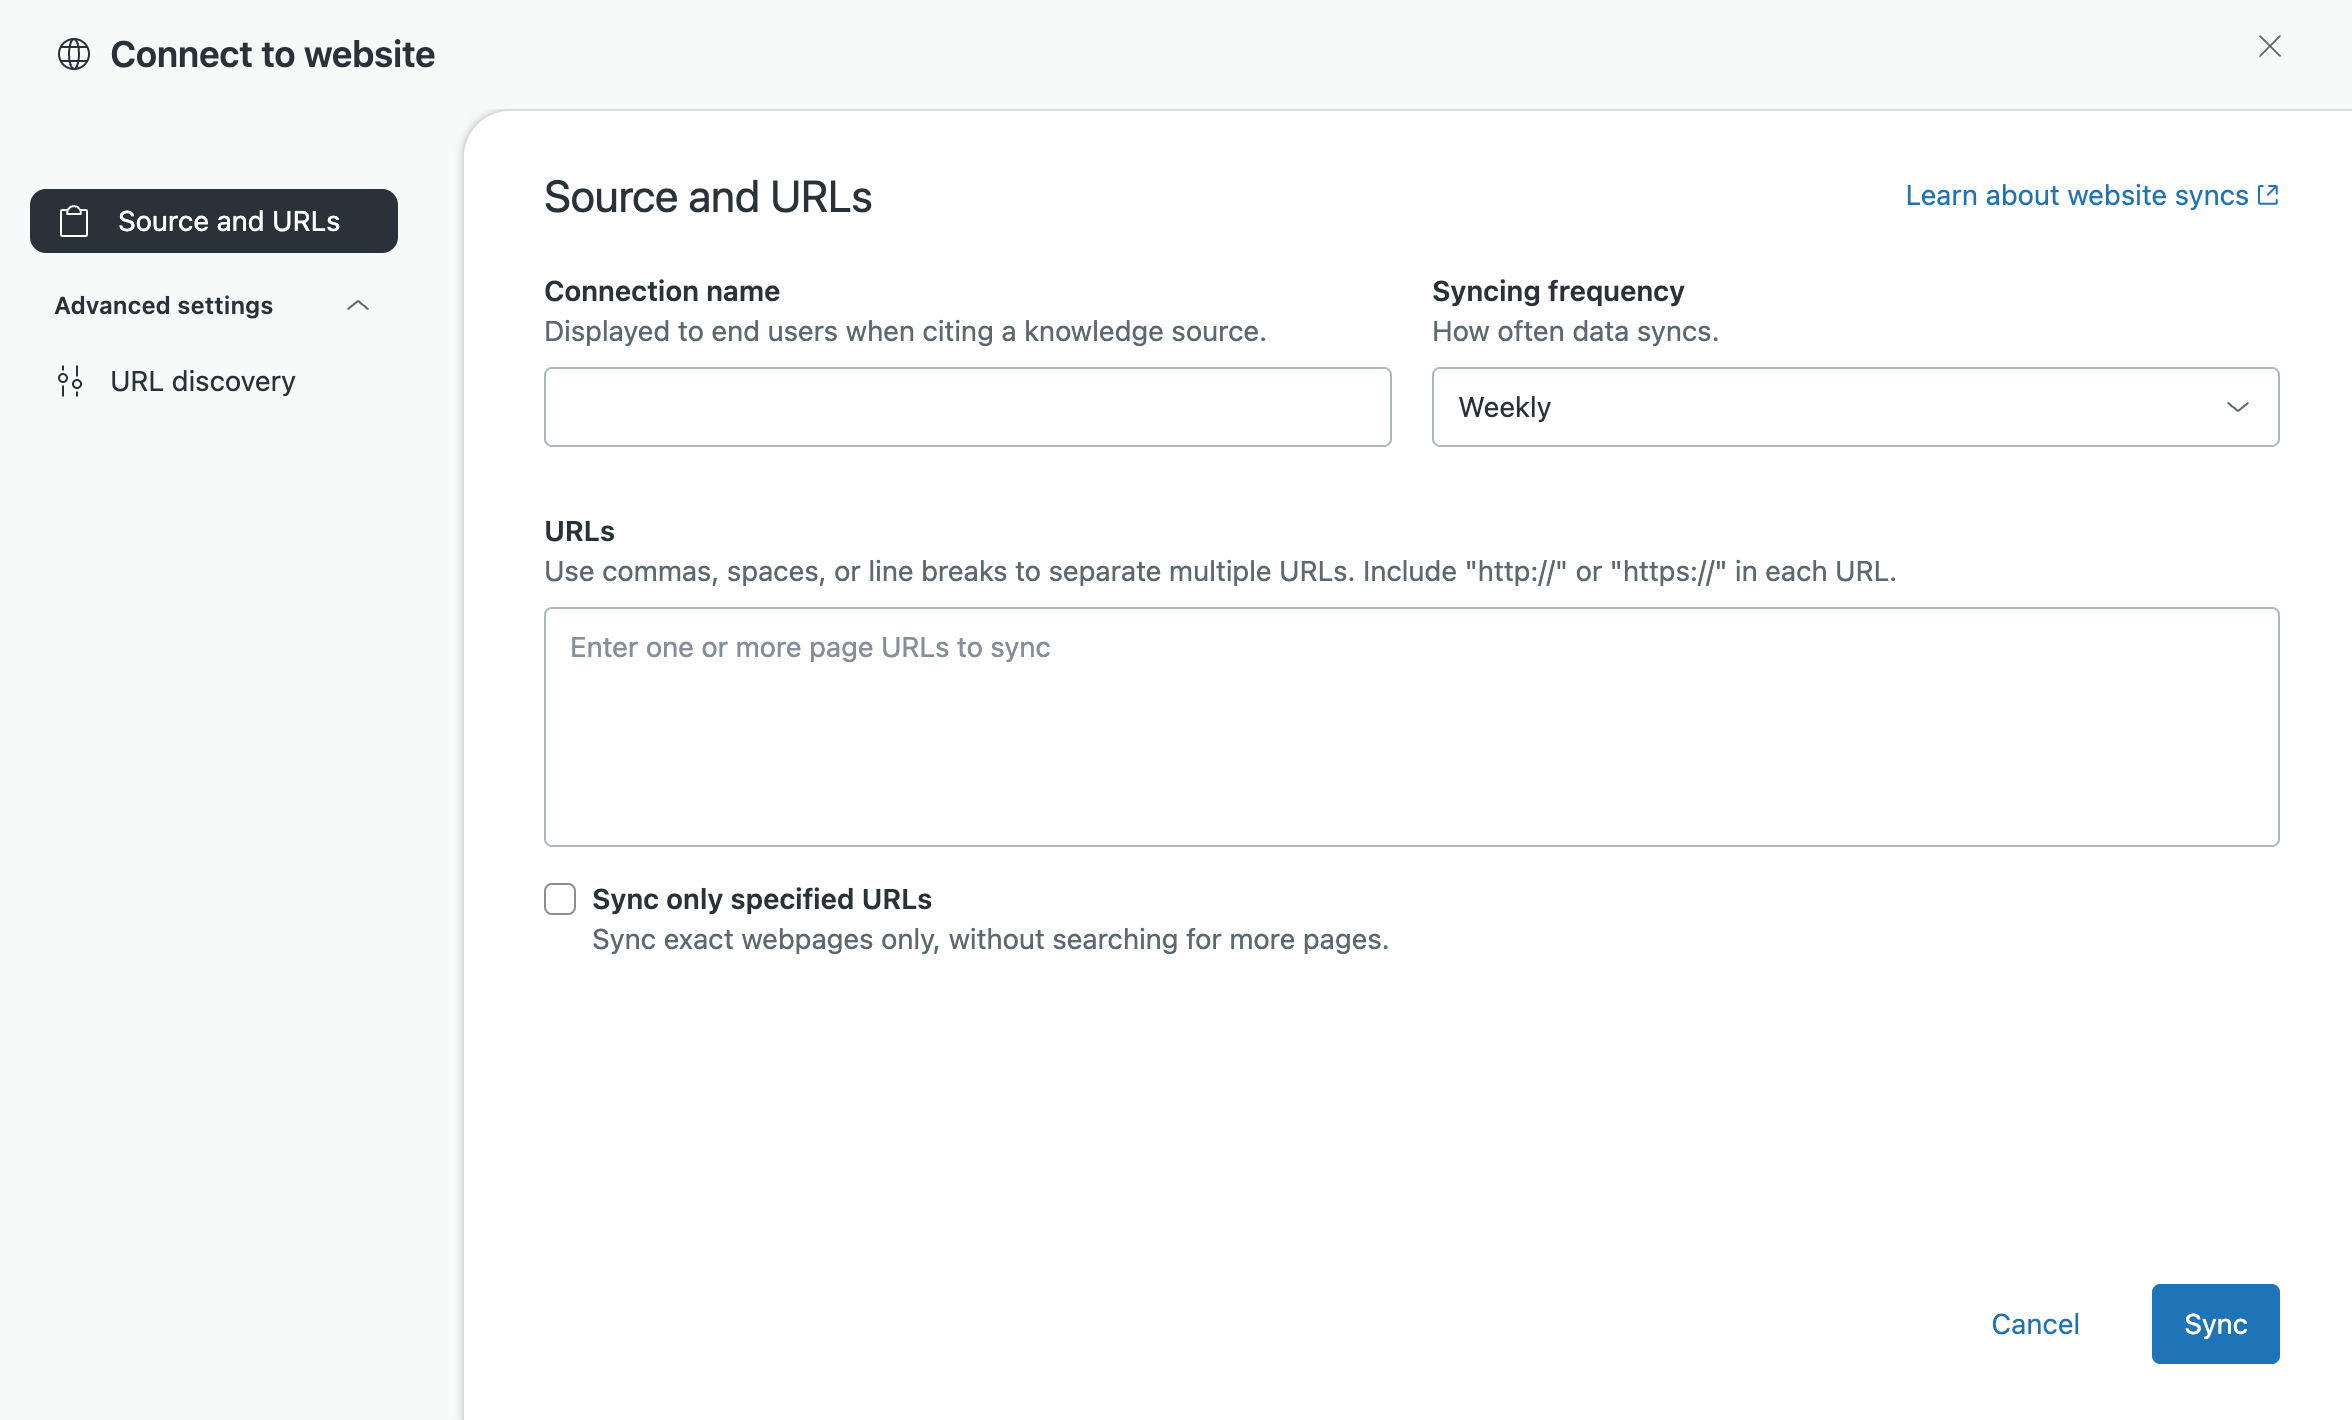
- Nella scheda Origine e URL , configura quanto segue:
- Nome connessione : Identifica il tuo web crawler nell’elenco di gestione dei crawler e viene usato per creare il valore dell’origine di ricerca usato come filtro nella ricerca nel centro assistenza .
- Frequenza di sincronizzazione : Intervallo durante il quale il web crawler esegue e sincronizza i dati con il tuo account Zendesk. Puoi accettare l’impostazione predefinita Settimanale oppure selezionare Mai (per una sincronizzazione una tantum), Giornaliero o Mensile.
- Configura quanto segue per specificare le pagine di cui eseguire la scansione:
- URL : Inserisci gli URL del dominio o delle pagine di cui vuoi eseguire la scansione (ad esempio, test.com/faq.htm). Puoi inserire fino a 500 URL in questo campo.
-
Sincronizza solo gli URL specificati : Specifica se eseguire la scansione solo degli URL specificati o di tutti gli URL all’interno delle pagine specificate.
- Seleziona la casella di spunta se vuoi eseguire la scansione solo degli URL inseriti. Ad esempio, se hai inserito example.com nel campo URL e hai selezionato questa casella di spunta, il crawler eseguirà la scansione e indicizzerà solo la pagina example.com.
- Deseleziona la casella di spunta se vuoi eseguire la scansione di ogni pagina collegata agli URL inseriti. Ad esempio, se hai inserito esempio.com e deselezionato questa casella di spunta, il crawler eseguirà la scansione e indicizzerà la pagina esempio.com e tutte le pagine collegate a tale pagina.
- (Facoltativo) Per aggiungere filtri URL che includeranno o escluderanno URL specifici in base a modelli di caratteri jolly specifici:
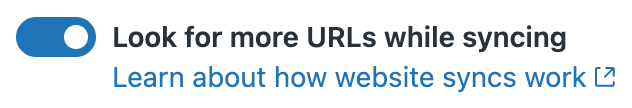
- Fai clic sulla scheda Impostazioni avanzate e attiva Cerca altri URL durante la sincronizzazione .
 Nota: Per ulteriori informazioni sui filtri URL e su come crearli, consulta Creazione di filtri URL per le sincronizzazioni dei siti web nell’ambito .
-
Se vuoi eseguire la scansione solo delle pagine,
- Abbina i modelli di caratteri jolly creati, seleziona Limita la sincronizzazione a modelli specifici e aggiungi i modelli da sincronizzare, quindi inserisci gli URL e i caratteri jolly da includere nel campo URL .
- Non corrispondono ai modelli di caratteri jolly creati, seleziona Escludi modelli specifici dalla sincronizzazione e inserisci gli URL e i caratteri jolly da escludere nel campo URL.
- Fai clic sulla scheda Impostazioni avanzate e attiva Cerca altri URL durante la sincronizzazione .
- Consulta il banner di riepilogo per verificare le impostazioni e apportare modifiche, se necessario.
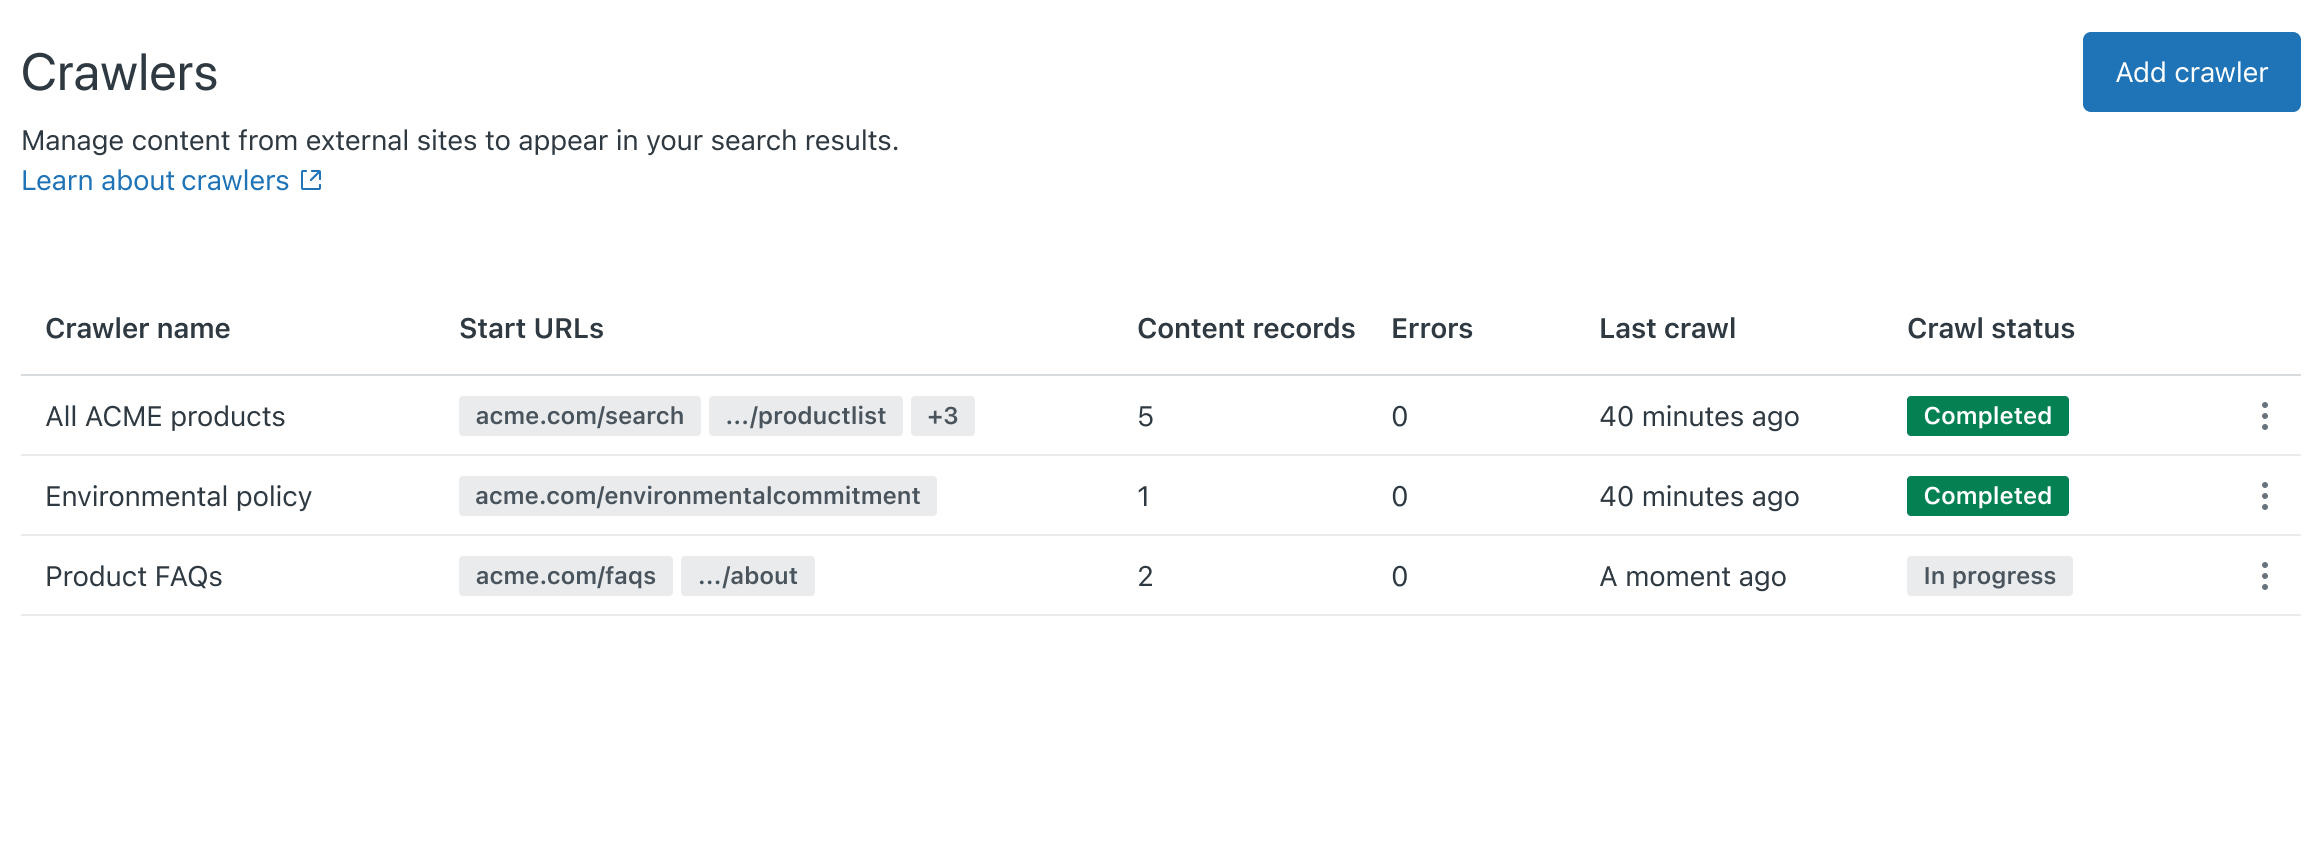
- Fai clic su Sincronizza. Il web crawler viene aggiunto alla pagina Crawler e inizia a eseguire la scansione delle pagine e a indicizzarne il contenuto. Il crawler verrà eseguito a intervalli definiti nel campo della frequenza di sincronizzazione (consulta il passaggio 6 sopra). Se il crawler non riesce, il proprietario del crawler riceverà una notifica email con suggerimenti per risolvere il problema. Il crawler riproverà periodicamente.Nota: Zendesk/External-Content è lo user agent per il web crawler. Per evitare errori del crawler dovuti al blocco delle richieste da parte del firewall, inserisci Zendesk/External-Content alla whitelist (o all’elenco consentiti).
- Ricerca nel centro assistenza, devi selezionare i contenuti da includere ed escludere nei risultati di ricerca del centro assistenza. Consulta Come includere contenuti esterni nei risultati di ricerca del centro assistenza.
- Sezione Knowledge del Pannello del contesto per gli agenti, consulta Configurazione di Knowledge nel Pannello del contesto.
Avvertenza sulla traduzione: questo articolo è stato tradotto usando un software di traduzione automatizzata per fornire una comprensione di base del contenuto. È stato fatto tutto il possibile per fornire una traduzione accurata, tuttavia Zendesk non garantisce l'accuratezza della traduzione.
Per qualsiasi dubbio sull'accuratezza delle informazioni contenute nell'articolo tradotto, fai riferimento alla versione inglese dell'articolo come versione ufficiale.